


 8 (905) 021-85-85
 info@medseo.ru
 пн-пт 9:00 — 18:00
 Александр Власов
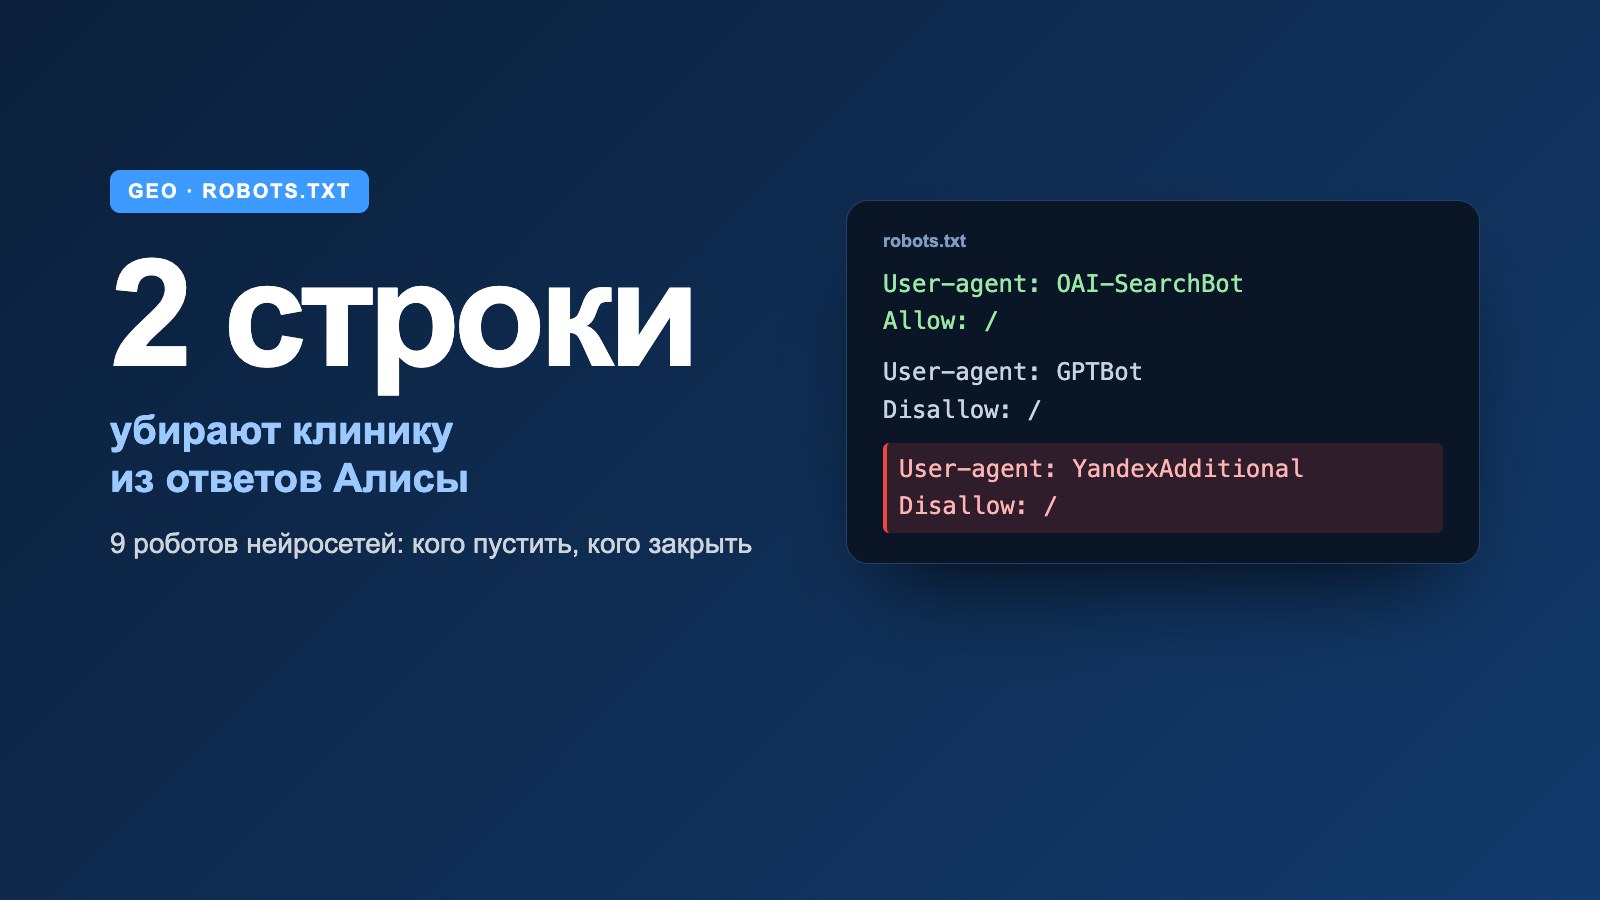
За 6 минут вы узнаете, каких из 9 роботов нейросетей пустить на сайт клиники, а каких можно закрыть, какие 2 строки в robots.txt тихо убирают её из ответов Алисы, и почему файл llms.txt не обязателен — по официальной документации OpenAI, Google, Anthropic, Perplexity и Яндекса.
Мы в агентстве делаем аудит присутствия клиник в нейросетях и рассказываем, что работает, на цифрах наших проектов.
В этой статье:
- роботы ChatGPT, Claude, Perplexity, Google и Яндекса — кто из них ищет, а кто собирает данные для обучения;
- готовый пример robots.txt для сайта клиники;
- проверка 18 сайтов клиник: что мы нашли в robots.txt;
- llms.txt — что это и нужен ли он клинике.
Почему это важно: сначала поиск, потом нейросеть
Чтобы нейросеть порекомендовала клинику, она должна прочитать её сайт. Если робот нейросети закрыт в robots.txt или важные страницы недоступны для индексации, сайт не попадёт в источники ответа, даже если клиника лучшая в районе.
«Чтобы попасть в быстрые ответы Яндекс Поиска, нужно прежде всего быть хорошо видным по SEO — как минимум в топ-10, максимум в топ-20, но точно не в топ-30: информацию для быстрого ответа Яндекс берёт из сайтов, которые занимают топ-10. Поэтому сайт должен быть доступен для индексации, нужны содержательные страницы процедур и понятная структура — базовые SEO-вещи»
Подробнее о выступлении — в новости «Александр Власов выступил спикером на InterCHARM 2026».
Роботы нейросетей: кто ищет, а кто учится
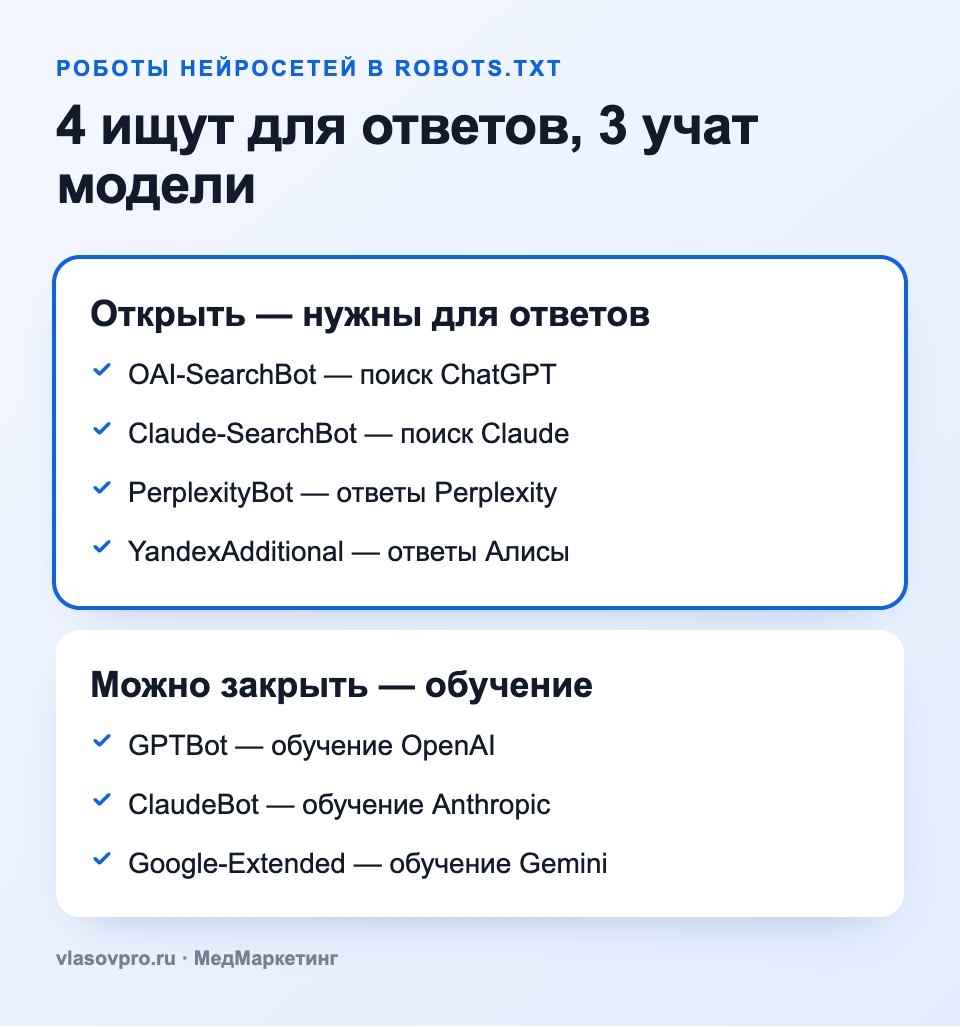
У каждой компании несколько роботов, и они делают разное. Одни собирают страницы для поиска и ответов — их клинике закрывать нельзя. Другие собирают данные для обучения моделей — их можно закрыть без потери видимости.
| Компания | Робот | Зачем приходит |
|---|---|---|
| OpenAI | OAI-SearchBot | Поиск в ChatGPT — от него зависит, появится ли сайт в ответах[1] |
| OpenAI | GPTBot | Обучение моделей[1] |
| OpenAI | ChatGPT-User | Открывает страницу по запросу пользователя, robots.txt не подчиняется[1] |
| Anthropic | Claude-SearchBot | Индексирует страницы для поиска в Claude[2] |
| Anthropic | Claude-User | Открывает страницу, когда пользователь просит Claude[2] |
| Anthropic | ClaudeBot | Обучение моделей[2] |
| Perplexity | PerplexityBot | Поиск и ссылки на сайты в ответах; для обучения не используется[3] |
| Google-Extended | Обучение Gemini; на Google Поиск не влияет[4] | |
| Яндекс | YandexAdditional | Ответы YandexGPT и поиска с Алисой[5] |
Два важных правила из официальной документации:
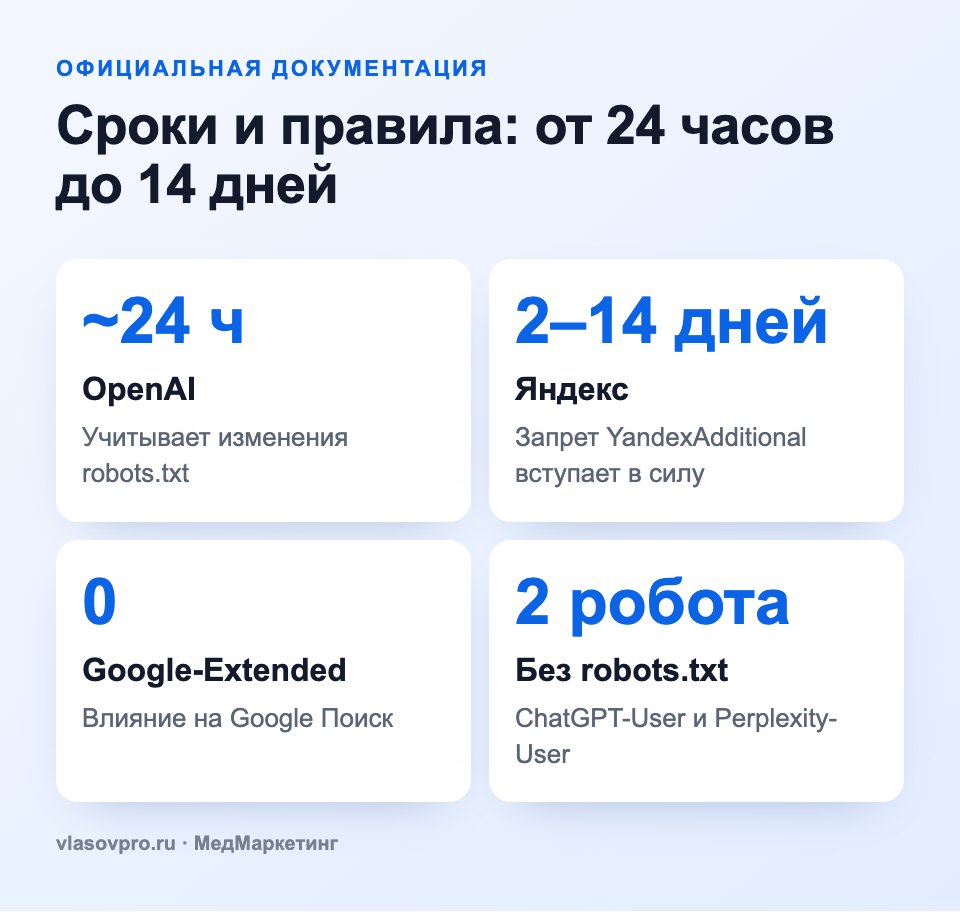
- роботов OpenAI можно настраивать по отдельности: разрешить OAI-SearchBot и запретить GPTBot — тогда сайт будет в поиске ChatGPT, но не пойдёт в обучение. Изменения в robots.txt системы OpenAI учитывают примерно через 24 часа[1];
- Google-Extended не влияет на показ сайта в Google Поиске и не используется для ранжирования. Отдельного робота у него нет — это только метка в robots.txt[4].
2 строки, которые убирают клинику из ответов Алисы
User-agent: YandexAdditional
Disallow: /
Робот YandexAdditional обрабатывает страницы для быстрых ответов YandexGPT и ответов поиска с Алисой[5]. Запрет для него убирает сайт из этих ответов — изменения применяются за 2–14 дней[6]. Иногда такие строки попадают в robots.txt случайно, вместе с «блоком против нейросетей» из готового шаблона.
Из нашей практики. В октябре 2026 года мы проверили robots.txt 18 сайтов клиник, с которыми работаем. 17 из них не ограничивают роботов нейросетей. На одном сайте нашли запрет сразу для 6 ИИ-роботов, включая YandexAdditional и PerplexityBot, — то есть сайт сам закрыл себя от ответов Алисы и Perplexity. Такие строки часто добавляют плагины и шаблоны «защиты контента», и владелец о них не знает.

Пример robots.txt для сайта клиники
Если клиника хочет быть в ответах нейросетей, но не отдавать тексты на обучение моделей, достаточно такого блока в дополнение к обычным правилам:
# Поиск и ответы нейросетей — открыто
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: YandexAdditional
Allow: /

# Обучение моделей — по желанию клиники
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /
Учтите: ChatGPT-User и Perplexity-User приходят по прямому запросу человека и robots.txt не подчиняются[1][3]. А роботы Anthropic, наоборот, понимают ещё и директиву Crawl-delay — с её помощью можно снизить частоту обходов[2].
llms.txt: нужен ли он клинике
llms.txt — это текстовый файл в формате Markdown в корне сайта с кратким описанием и ссылками на главные страницы. Его предложил Джереми Ховард в сентябре 2024 года; это неофициальный стандарт[7].
Для Google он не нужен: по справке Google Поиска, чтобы попасть в AI Overviews и режим ИИ, не требуется создавать специальные файлы или особую разметку — достаточно, чтобы страница была проиндексирована и могла показываться со сниппетом[8].
Наш совет: llms.txt не помешает, но начинать нужно не с него, а с открытых роботов, индексации и содержательных страниц услуг.
Чек-лист: 5 проверок за 15 минут
- Откройте ваш-сайт.ru/robots.txt и найдите строки с GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot, YandexAdditional.
- Убедитесь, что для поисковых роботов ИИ (OAI-SearchBot, Claude-SearchBot, PerplexityBot, YandexAdditional) нет
Disallow: /. - Проверьте, что страницы услуг, врачей и цен не закрыты в robots.txt и мета-тегом noindex.
- Проверьте в Яндекс Вебмастере и Google Search Console, что эти страницы в индексе.
- Посмотрите, что текст услуги и цены видны в исходном HTML, а не появляются только после загрузки скриптов.
Что можно сделать самим, а где нужна команда
Открыть robots.txt и убрать лишний запрет для YandexAdditional — по силам администратору сайта за 5 минут.
Сложнее — понять, по каким запросам нейросети рекомендуют конкурентов, а не вас, что о клинике пишут на внешних площадках и каких страниц не хватает сайту. Если хотите, чтобы это сделала команда, — посмотрите, что входит в аудит AI-присутствия клиники.
Частые вопросы
Что такое GPTBot?
Робот OpenAI, который собирает страницы для обучения моделей. Его запрет в robots.txt не убирает сайт из поиска ChatGPT — за поиск отвечает другой робот, OAI-SearchBot.
Что такое llms.txt?
Файл в формате Markdown в корне сайта с кратким описанием и ссылками на главные страницы для нейросетей. Это неофициальный стандарт; для Google Поиска он не обязателен.
Как проверить robots.txt сайта?
Откройте адрес ваш-сайт.ru/robots.txt в браузере. В Яндекс Вебмастере и Google Search Console есть инструменты, которые показывают, разрешена ли конкретная страница для робота.
Как создать llms.txt?
Создайте текстовый файл llms.txt в корне сайта: заголовок с названием клиники, краткое описание в цитате и списки ссылок на главные страницы — услуги, врачей, цены, контакты.
Источники
- OpenAI. Overview of OpenAI Crawlers. developers.openai.com
- Anthropic. Does Anthropic crawl data from the web, and how can site owners block the crawler? support.claude.com
- Perplexity. Perplexity Crawlers. docs.perplexity.ai
- Google Поиск. Распространённые поисковые роботы Google. developers.google.com
- Справка Яндекс Вебмастера. Как проверить, что робот принадлежит Яндексу. yandex.ru
- Справка Яндекс Вебмастера. Быстрые ответы. yandex.ru
- llms.txt — предложение формата. llmstxt.org
- Google Поиск. ИИ-функции и ваш сайт. developers.google.com
Комментарии
Пока никто не комментировал. Задайте вопрос — Александр ответит.